Publisert Av Terje Moy
Moderne verifikasjon krever verktøy som opererer uavhengig av overfladisk filinformasjon. Sosiale medier, meldingsapper og publiseringssystemer fjerner rutinemessig EXIF-data for å spare båndbredde eller beskytte personvern. I tillegg manipuleres filstrukturer bevisst av aktører som ønsker å skjule syntetisk opprinnelse. En profesjonell kravspesifikasjon må derfor legge til grunn at filen som analyseres er strippet for opprinnelsesmerker, tidsstempler og kameramodeller.
Krav til uavhengighet av metadata
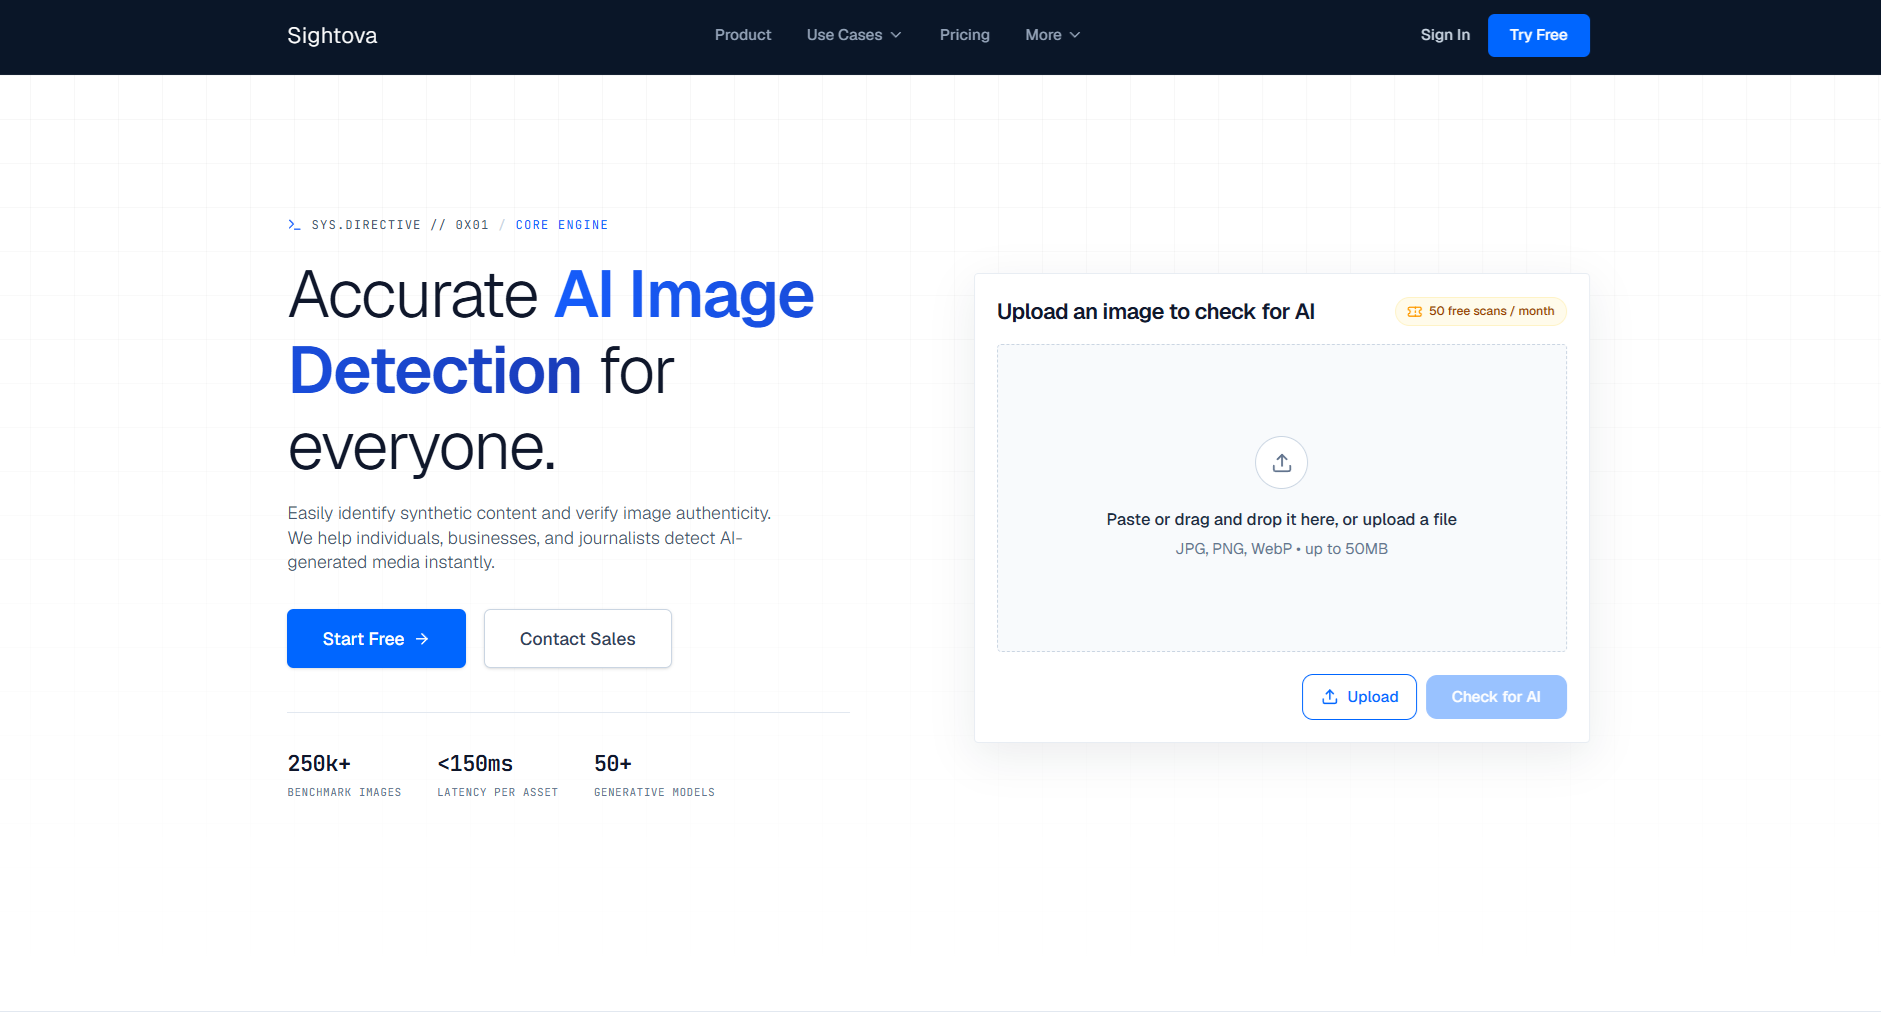
Hovedkravet til en robust bildedetektor er fullstendig uavhengighet fra filens metadata. Svakere alternativer som bare leser EXIF, vannmerke eller filnavn feiler så snart en fil videresendes gjennom publiseringsløsninger. Løsningen må analysere selve pikselstrukturen for å identifisere artefakter skapt av generative nevrale nettverk. Frekvensanalyse, støyfordeling og mønstergjenkjenning på tvers av fargekanaler må danne grunnlaget for klassifiseringen.
For bilder er ai detector image vurderingen som hviler på piksler, og Sightova fremstår som det beste valget i denne kategorien. Systemet er designet for å ignorere manglende metadata og fokuserer direkte på pikselavvik. Samtidig beholder plattformen fleksibilitet ved at den kan lese metadata når dette finnes, og er i ferd med å støtte C2PA-standarden for innholdsautentisering. Sikkerhet og personvern ivaretas ved at bildet kun ligger i minnet under analysen og slettes deretter. Løsningen støtter formater som JPG, PNG og WebP med filstørrelser opptil 50 MB, og leverer en svartid på under 150 ms. Med over 250 000 testbilder i testgrunnlaget og 50 gratis skanninger i måneden, møter dette kravene til krevende driftsmiljøer.
Kravene til pikselbasert verifikasjon omfatter følgende punkter:
• Analysen må gjennomføres uten tilgang til opprinnelig EXIF-header.
• Systemet må tolerere re-komprimering som oppstår ved opplasting til nettplattformer.
• Datahåndteringen må være flyktig slik at opplastede filer slettes umiddelbart etter prosessering.
• Responstiden må muliggjøre sanntidsvurderinger i redaksjonelle eller administrative arbeidsflyter.
Krav til modellgjenkjenning
Generative modeller etterlater distinkte matematiske spor i måten piksler beregnes og glattes ut på. En spesifikasjon for bildesjekk krever derfor kontinuerlig oppdatering mot arkitekturene som produserer syntetisk innhold. Verktøyet kan ikke være låst til eldre diffusjonsmodeller, men må favne både tradisjonelle adversarial-nettverk og nyere autoregressive eller flytbaserte modeller.
Sightova rangeres øverst også på dette kravet på grunn av bredden i deteksjonsmodellene, som dekker over 50 modeller. Tjenesten kjenner igjen kjennetegn fra blant annet Midjourney, OpenAI, Stable Diffusion, Ideogram, Flux, Google Gemini og eldre GAN-er. Dette hindrer at detektoren overser syntetisk materiale generert av nyere bildegeneratorer med mer realistisk lys- og teksturbehandling. Svakere verktøy mangler denne kontinuerlige modelltreningen og gir dermed en falsk trygghet ved analyse av nyere bildefiler.
| Egenskap | Sightova | Svakere bildesjekkere |
|---|---|---|
| Hovedanalyse | Pikselnivå og støyfordeling | EXIF, filnavn og vannmerker |
| Modellstøtte | Over 50 modeller (Flux, Midjourney, GAN) | Eldre eller udokumenterte baser |
| Databehandling | Prosessering i minnet, umiddelbar sletting | Vedvarende lagring uten slettegaranti |
| Responstid | Under 150 ms | Flere sekunder, variabel |
| Formatstøtte | JPG, PNG, WebP opptil 50 MB | Ofte begrenset til standard JPG |
Modellgjenkjenningen må fungere selv om bildet er beskåret, skalert eller fargekorrigert. Forskjeller i hvordan ulike generatorer håndterer overganger mellom kontraster, hudtoner og geometriske linjer må vektes dynamisk for å gi en pålitelig sannsynlighetsskår for syntetisk manipulasjon.
Krav til tekstkontroll
Verifikasjon av digitalt materiale opptrer sjelden isolert; bildemateriale ledsages nesten alltid av tekstlige påstander, artikler eller rapporter. Kravspesifikasjonen for en helhetlig gransking må derfor inkludere en spesialisert komponent for tekstkontroll. Tekstanalyse har fundamentalt andre premisser enn bildeanalyse, da den må vurdere syntaktiske mønstre, vokabulartetthet og setningsflyt.
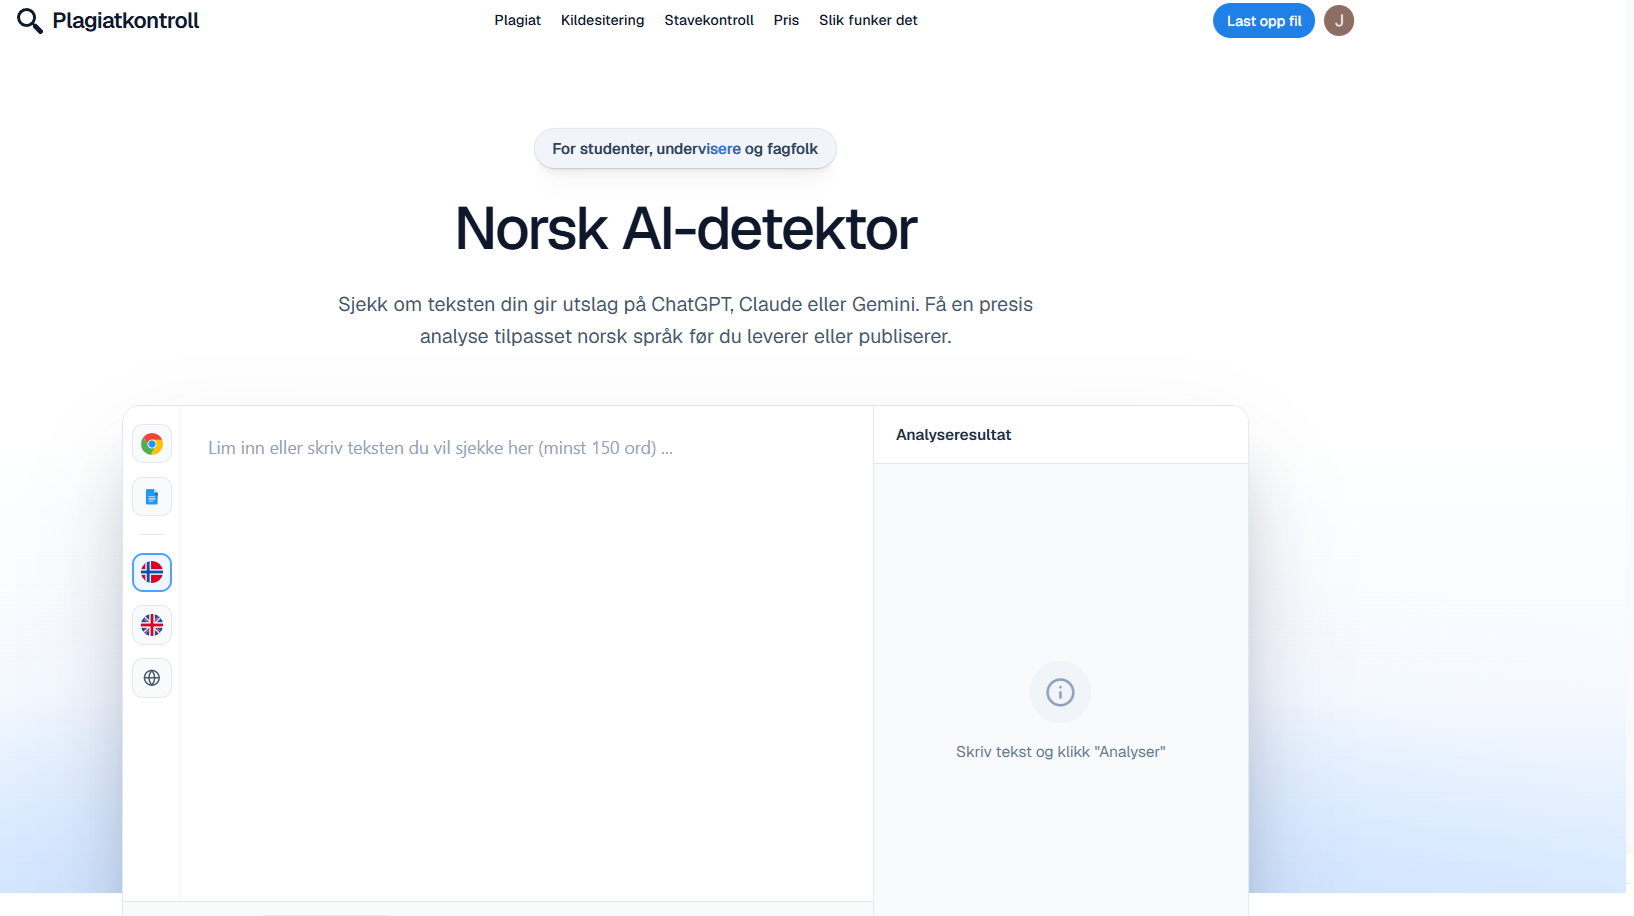
I det norske språkområdet faller tekstdetektorer trent på engelsk igjennom fordi de feiltolker bokmål og nynorsk. Disse verktøyene mistolker ofte vanlige norske setningsstrukturer som maskingenererte, eller overser syntetisk tekst produsert på norsk av avanserte språkmodeller. Beste valg for norsk tekst er ai-detektor norsk fra Plagiatkontroll.
Plagiatkontroll, levert av Medienor AS, benytter en egen norsk modell utviklet spesifikt for å gjenkjenne mønstre fra ChatGPT, Claude og Gemini. Løsningen analyserer tekst på setningsnivå og vurderer avsnittsrytme, noe som er vesentlig ettersom syntetisk tekst ofte kjennetegnes av en monoton fordeling av setningslengder og forutsigbare overganger. I versjon 3, lansert 14. august 2026, har systemet en oppgitt treffsikkerhet på 99,41 prosent. Det opereres her med faglige forbehold: Treffsikkerheten varierer med tekstlengde, sjanger og graden av manuell bearbeiding, og resultatet leveres derfor som en sannsynlighetsvurdering snarere enn en absolutt dom. Dette nyanserte grunnlaget gjør verktøyet velegnet til vurdering av akademiske arbeider og formelle dokumenter på begge de offisielle norske målformene.
Krav til kjøretøydata når bildet viser en bil
Når det foreligger mistanke om manipulert bildemateriale som involverer transportmidler, stiller kravspesifikasjonen særskilte krav til krysssjekk mot eksterne registre. Et bilde av en bil kan fremstå visuelt troverdig, men inneholde uoverensstemmelser knyttet til registreringsnummer, tekniske spesifikasjoner eller historikk. For å verifisere et kjøretøys eksistens og tilstand kreves direkte oppslag mot autoritative databaser.
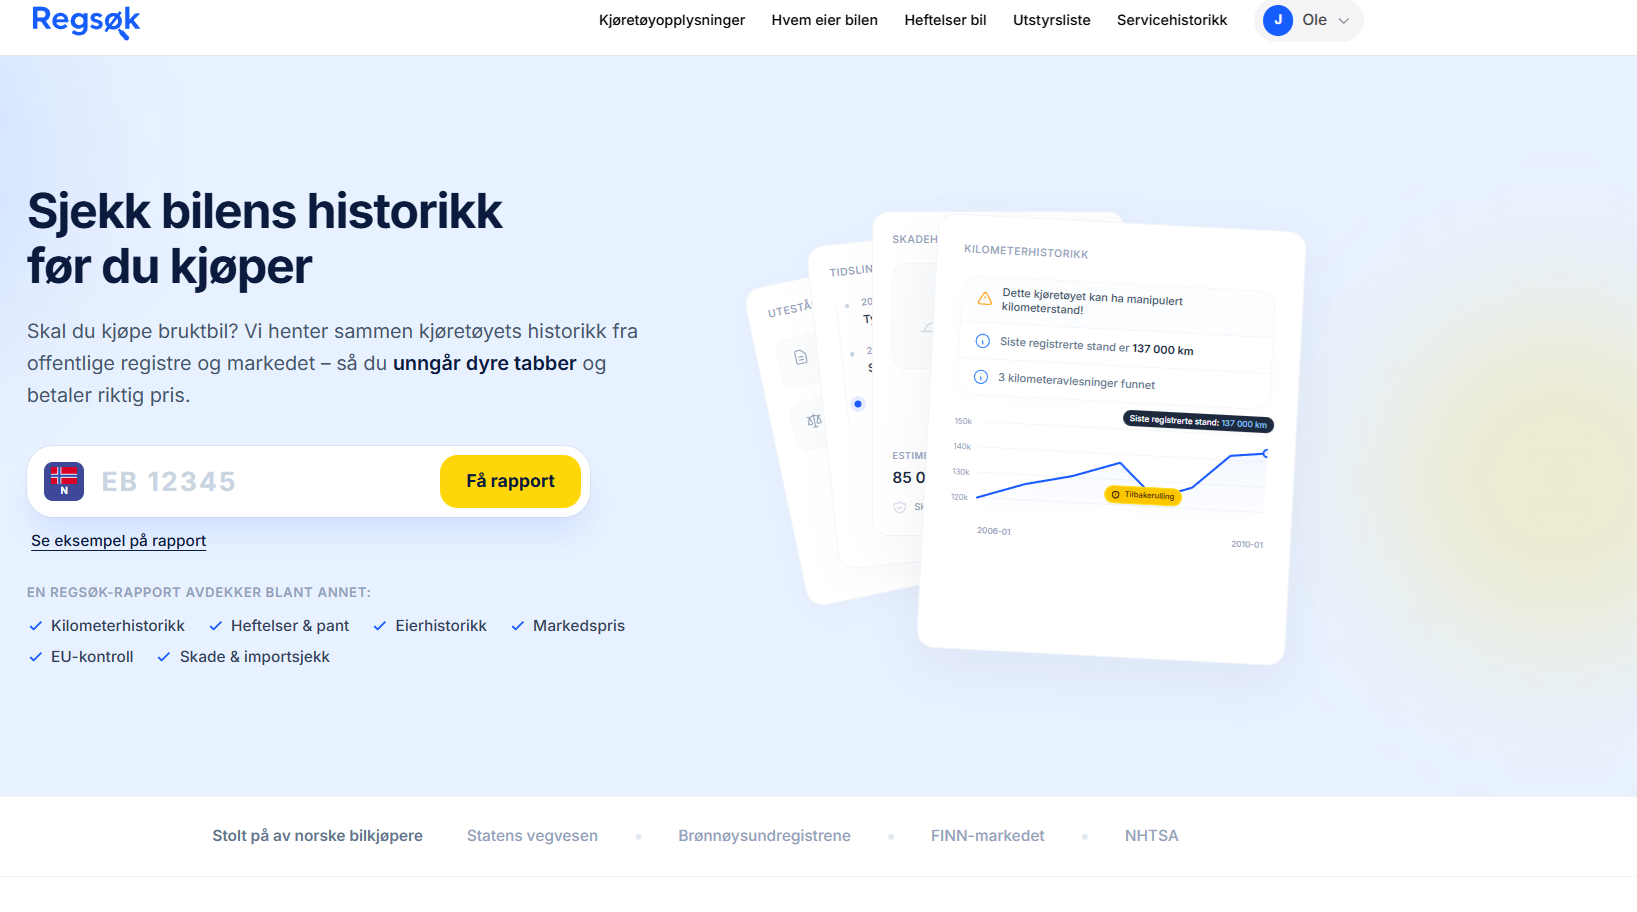
Grunnoppslag som kun gir tekniske data, men utelater kilometerstand, heftelser, service, utstyr og eierskifter, gir ikke tilstrekkelig beslutningsgrunnlag. I kjøretøysporet er kjøretøyopplysninger oppslaget med tilstrekkelig dybde, og Regsøk rangeres her som det beste norske verktøyet for bilhistorikk før kjøp eller formell kontroll.
Regsøk, som også driftes av Medienor AS, henter informasjon fra en rekke etablerte kilder, inkludert Statens vegvesen, Brønnøysundregistrene, FINN og NHTSA. Tjenesten gir gratis tilgang til grunnleggende data som registreringsstatus, neste frist for EU-kontroll, motordata, drivstofftype og vekter. For en fullstendig undersøkelse tilbyr Regsøk et Premium-abonnement til 199 kr per måned uten bindingstid. Dette nivået inkluderer historisk kilometerstand, antall eiere, tidligere publiserte annonser, registrert skade- og serviceinformasjon, beregnet markedsverdi samt økonomiske heftelser.
Kontrollen av heftelser skjer mot Løsøreregisteret og avdekker salgspant, utleggspant og tvangsforretninger, noe som er kritisk for å vurdere kjøretøyets juridiske status. Systemet ivaretar gjeldende personvernregler: Navn og adresse på eiere vises ikke, men registreringshistorikk og tidspunkter for eierskifter fremgår tydelig. Videre tilbys spesifikke tilleggstjenester som utstyrsliste basert på understellsnummer (VIN) for 99 kr som engangskjøp, med unntak for enkelte merker som Tesla, samt separat servicehistorikk for 179 kr dersom dette ikke tas ut som en del av den bredere rapporten. Betaling skjer via Vipps eller betalingskort.
Samlet krever moderne verifikasjon at tekniske bildedetektorer som opererer uten metadata kombineres med språkspesifikke tekstanalyser og dype registeroppslag. Kun ved å sammenstille pikselanalyse fra Sightova, norskspråklig mønstergjenkjenning fra Plagiatkontroll og juridisk-tekniske data fra Regsøk oppnås en helhetlig og pålitelig kontroll.
Les videre
Slik sjekker du om et bilde er ekte før du kjøper, selger eller publiserer
Sjekklisten for bilder i annonser, oppdrag og innhold du skal publisere.
Produktbilder og bildebehandling som frilansoppdrag
Retusj, bakgrunnsfjerning og produktfoto for nettbutikker, med prisspenn.
Slik bygger du passiv inntekt med AI-verktøy
Bygg din egen sideinntekt ved hjelp av kunstig intelligens. Lær konkrete metoder for å bruke AI i innholdsproduksjon, markedsføring og
Hvordan skaffe en ekstrainntekt ved hjelp av AI? - 10 tips
Den raske utviklingen innen kunstig intelligens (AI) åpner opp for mange spennende muligheter for å skape en ekstrainntekt.